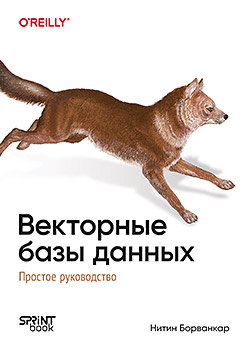
Векторные базы данных стали одной из основ современного ИИ: на них держатся семантический поиск, рекомендательные системы и RAG-системы. При этом многие разработчики знают о них лишь в общих чертах, а сведения разбросаны по документации, блогам и репозиториям.Нитин Борванкар собрал информацию в одно практическое руководство. Он объяснил, как и почему работают векторные БД: от эмбеддингов и Word2Vec до индексов FAISS и HNSW. Затем показал, как векторные расширения превращают привычные SQLite и PostgreSQL в векторные базы данных и как строить на них RAG-систему. Все примеры написаны на Python и запускаются на обычном компьютере, без облачных сервисов и GPU.
Пока нет отзывов
О научном редакторе русского издания: Кирилл Быков работает старшим аналитиком-разработчиком во “ВКонтакте”. Поддерживает внутреннюю MapReduce-систему, разрабатывает платформу A/B-тестирования, занимается дата-инженерией и развивает аналитические инструменты. Преподает основы машинного и глубокого обучения, программирование на Python и продуктовую аналитику в МФТИ, НИУ ВШЭ и Центральном университете.
Поймете, как связаны эмбеддинги, векторные базы данных и LLM и чем поиск по смыслу отличается от поиска по словам.
Превратите PostgreSQL и SQLite в векторные базы данных с помощью расширений.
Обойдете типичные ловушки: обрыв связи с индексом после обновления, поредевшую после фильтров выдачу, замедление HNSW.
Соберете гибридный поиск, в котором смысл и ключевые слова работают вместе.
Создадите RAG-системы, которые работают на вашем компьютере, без облака.
Заказ обратного звонка
Спасибо за обращение!
Скоро с вами свяжется наш менеджер
Мы используем файлы cookie для улучшения работы сайта. Продолжая его использование, вы соглашаетесь с нашей
Политикой конфиденциальности.