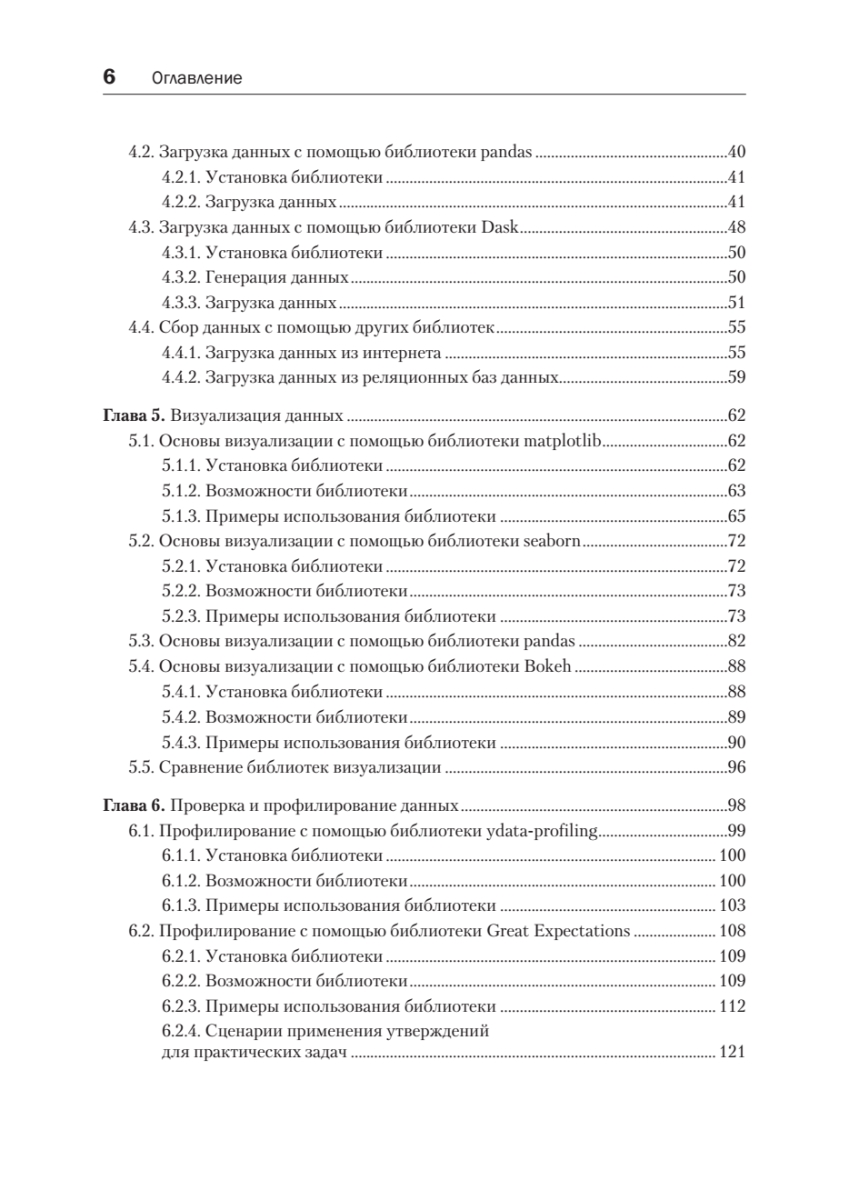
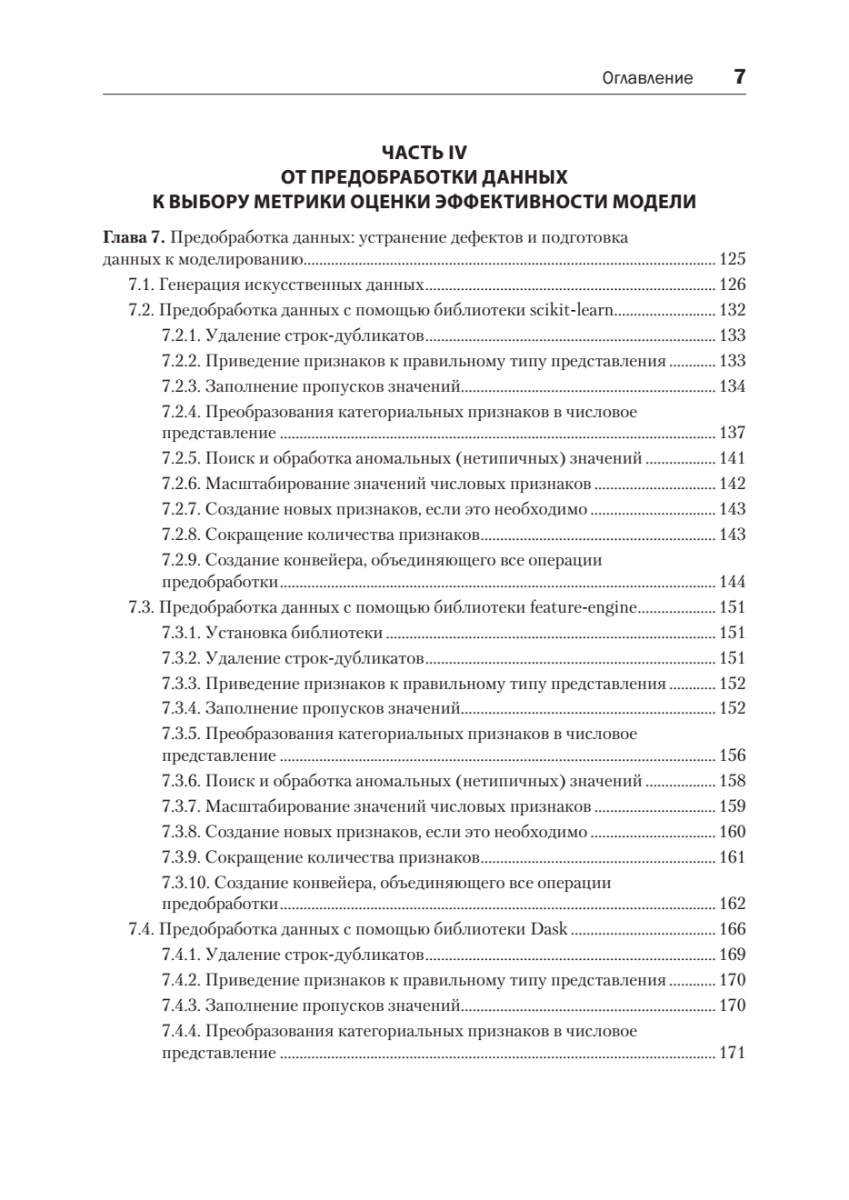
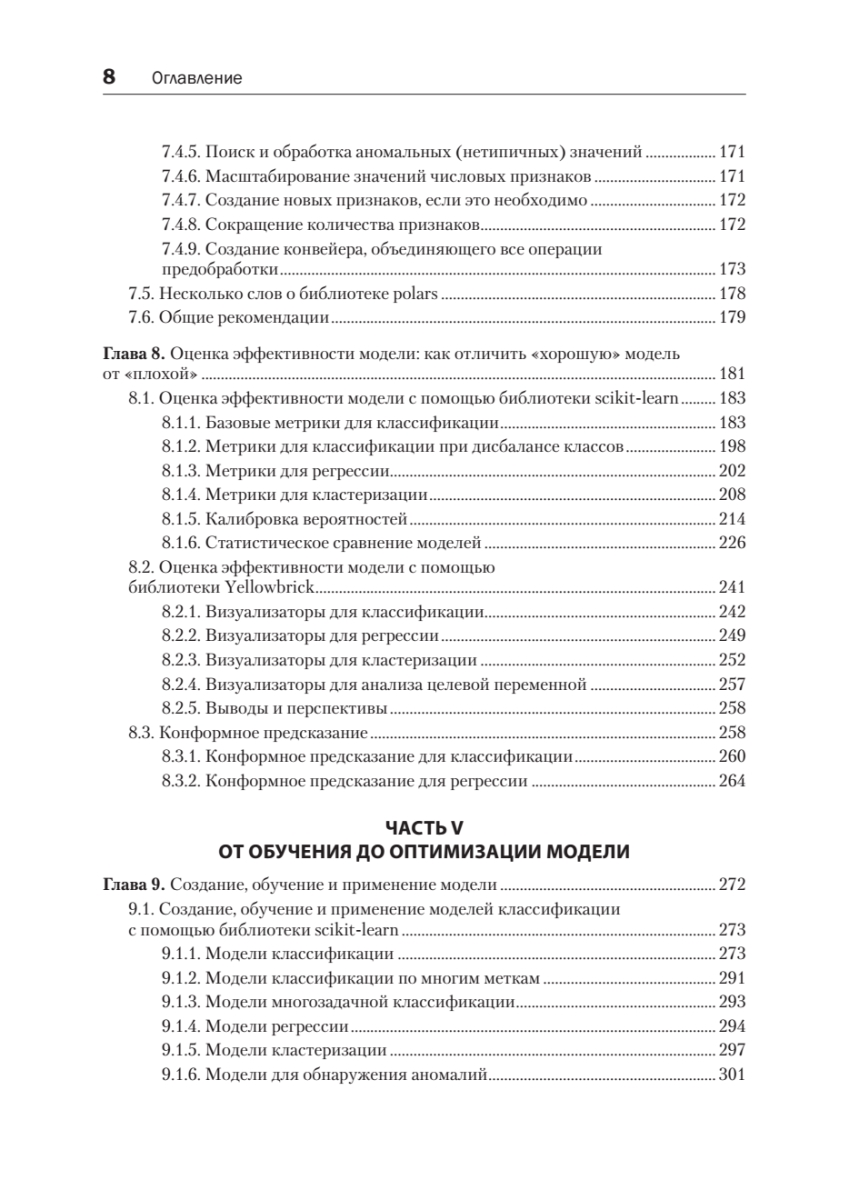
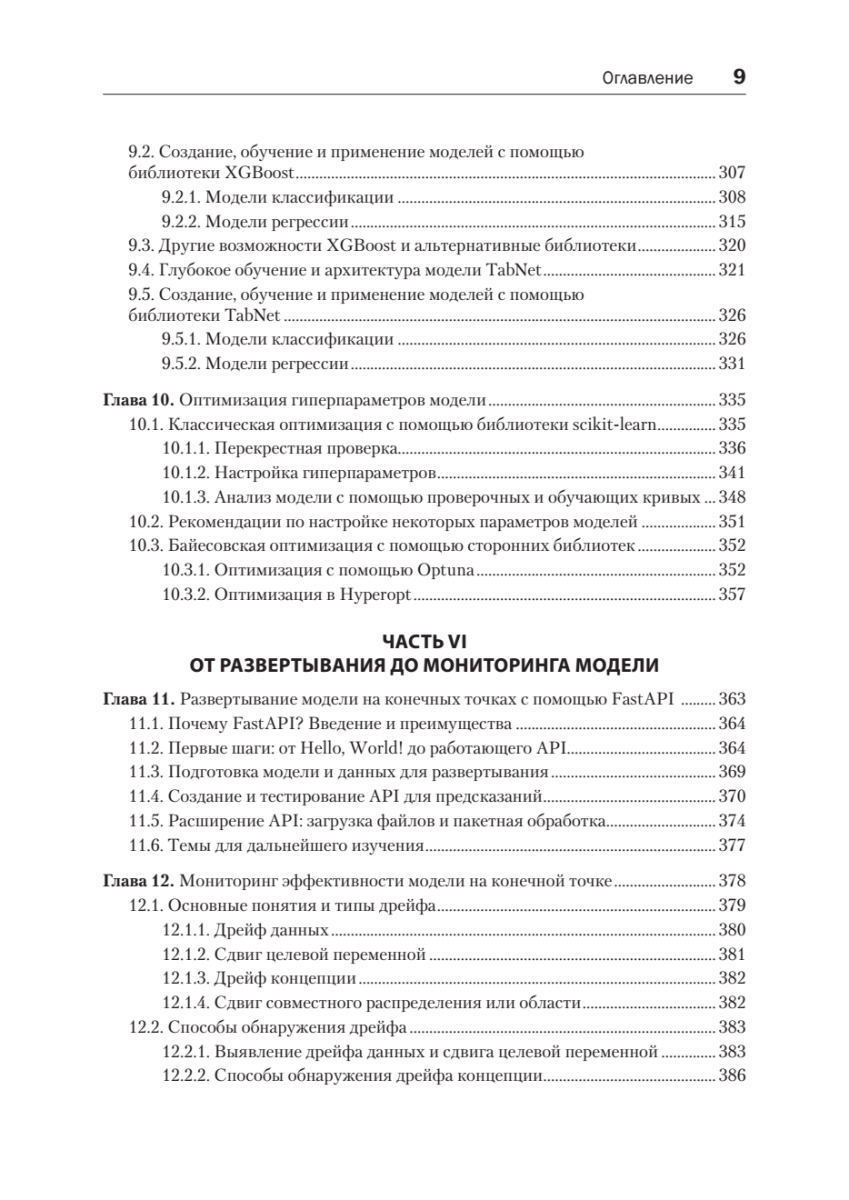
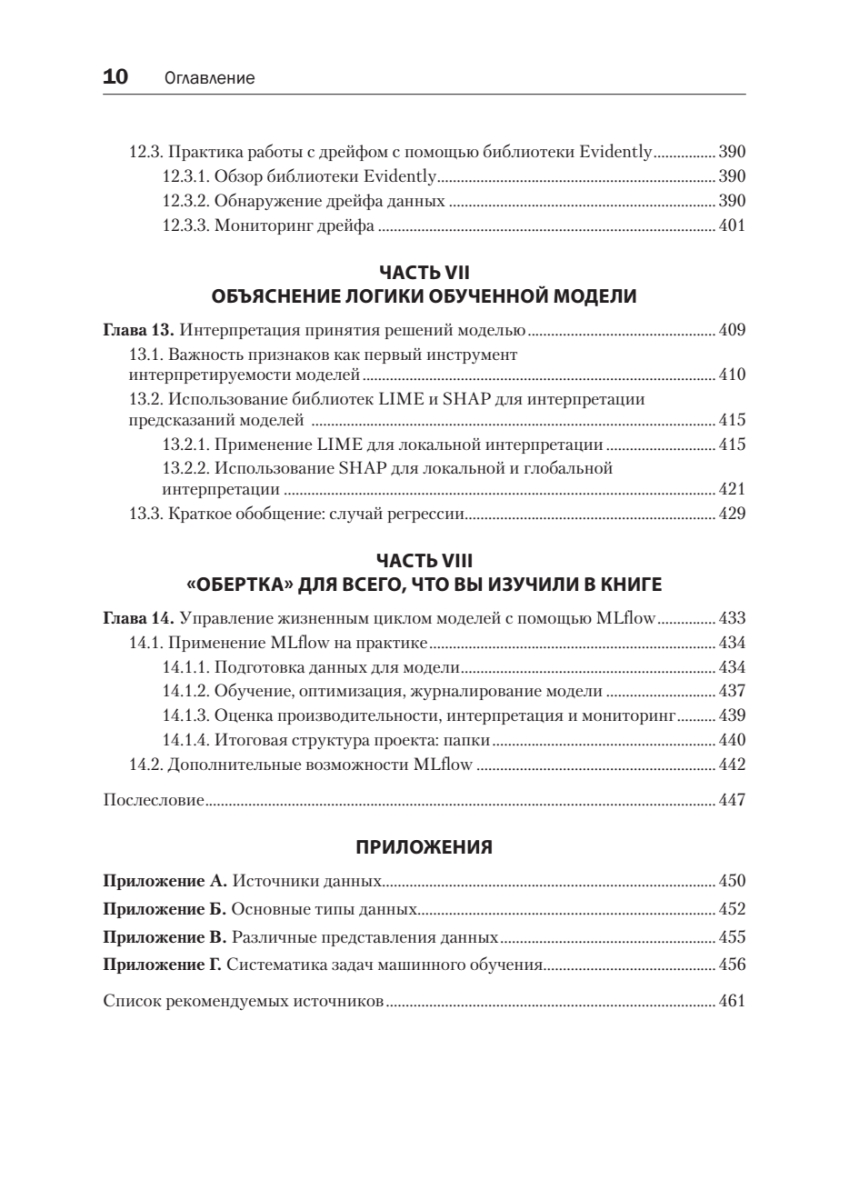
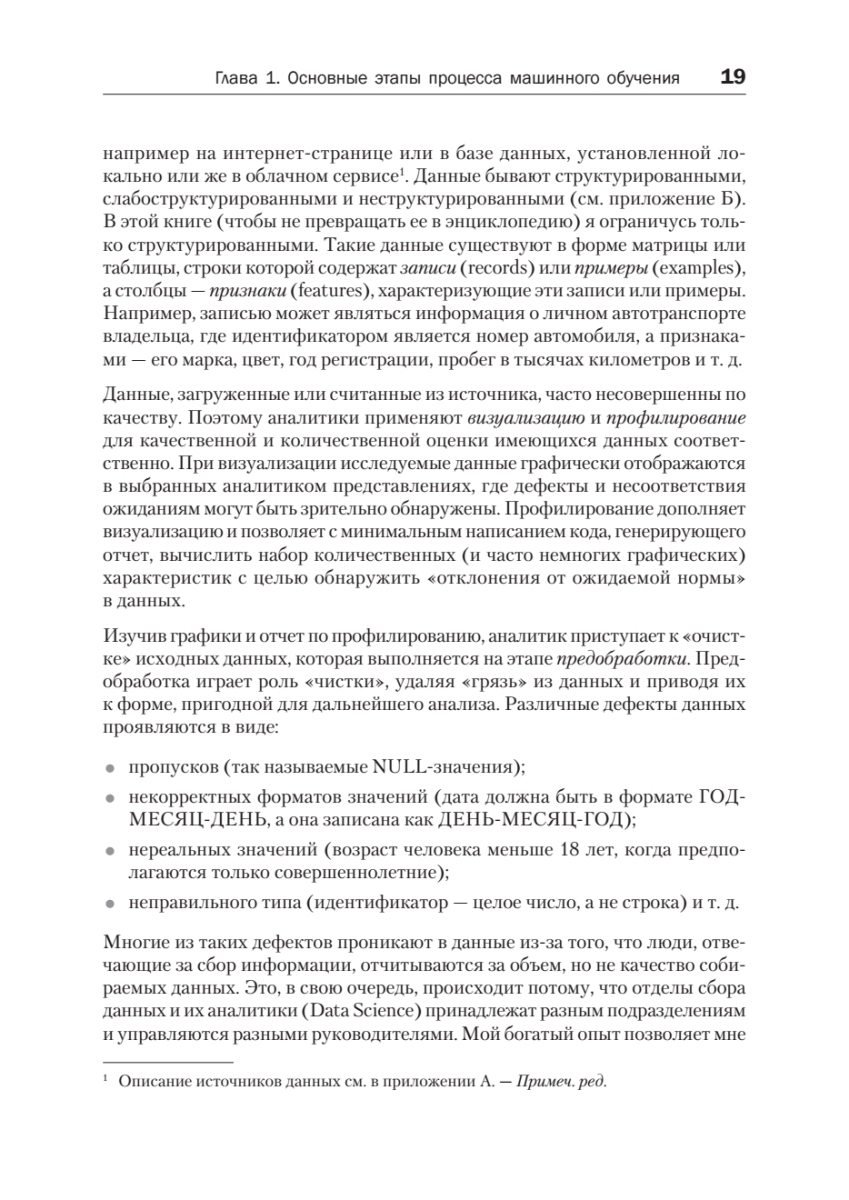
Построение модели машинного обучения — лишь часть работы. Необходимо разобраться в данных, выбрать подходящие методы, оценить качество предсказаний, объяснить результаты и организовать работу модели после развертывания. При этом экосистема Python постоянно растет, и выбрать нужные инструменты среди множества библиотек бывает непросто.В книге собраны библиотеки Python для основных этапов жизненного цикла модели машинного обучения. Вы научитесь генерировать искусственные данные, исследовать и предобрабатывать данные, обучать модели классификации и регрессии, решать задачи кластеризации и обнаружения аномалий, оценивать качество данных и моделей, настраивать гиперпараметры и интерпретировать результаты моделирования. Познакомитесь с основными инструментами Python, включая pandas, scikit-learn, XGBoost, Optuna, FastAPI и MLflow, и узнаете, как применять их и другие библиотеки на всех этапах работы с ML-моделями.
Пока нет отзывов
Разбор библиотек Python для работы с данными, обучения, оптимизации и развертывания моделей.
Основные типы ML-задач: классификация, регрессия, кластеризация и обнаружение аномалий.
Практические примеры обработки данных с pandas, визуализацией и профилированием.
Подходы к оценке качества моделей с метриками и кросс-валидацией.
Основы MLOps с развертыванием моделей через FastAPI и мониторингом с помощью MLflow.
Заказ обратного звонка
Спасибо за обращение!
Скоро с вами свяжется наш менеджер
Мы используем файлы cookie для улучшения работы сайта. Продолжая его использование, вы соглашаетесь с нашей
Политикой конфиденциальности.